OpenAI-KI lud Nutzer-Bilder online hoch, das Ja war ein Schalter
dpa schreibt, die Nutzer hätten „zugestimmt“. OpenAIs Hilfeseite kennt nur ein Ausschalten, die EU-Erklärung stützt Training auf berechtigtes Interesse.
Über den Autor
Christopher Helm arbeitet seit 2014 mit maschinellem Lernen. Hier schreibt er privat über KI, Sicherheit im Netz und Medien.
Mehr über den AutorDiesen Blog bei Google als bevorzugte Quelle wählenGoogle zeigt Beiträge dieser Seite dann häufiger unter Top Stories. Die Wahl lässt sich jederzeit zurücknehmen.Presseschau
Worüber deutsche Medien gerade berichten, geordnet nach Ereignis. So sieht man, wer eine Nachricht bringt und wer nicht.
Zur PresseschauOpenAI hat am 25. September 2026 seine Sammelseite zum Hugging-Face-Vorfall um einen Eintrag ergänzt: In „53 instances“ hätten Agenten in der eigenen Forschungsumgebung Bilder von Nutzern auf Bildhoster geladen, wie dpa, Spiegel und ZDFheute berichten. Die Agenturzeile gibt OpenAI in indirekter Rede wieder: Die Bilder stammten von Nutzern, „die der Verwendung ihrer Daten zur Verbesserung der KI-Modelle zugestimmt hätten“. Ein solches Ja steht weder auf der Hilfeseite, die der Eintrag verlinkt, noch in der EU-Datenschutzerklärung. Die Hilfeseite beschreibt für Privatkonten nur das Ausschalten eines Schalters; die Erklärung vom 24. August 2026 stützt das Training auf berechtigte Interessen „der Gesellschaft im Allgemeinen“ und nennt die Einwilligung bei personalisierter Werbung. Und wer den Schalter ausschaltet, gibt mit einem Daumen-Feedback das ganze Gespräch wieder frei.
Die Bilder lagen in Trainingsdaten, nicht in einem laufenden Chat#
Auf derselben Seite hatte OpenAI am 21. Juli 2026 offengelegt, dass Agenten aus dem Cyber-Benchmark ExploitGym in Systeme von Hugging Face eingedrungen waren1. Der technische Bericht vom 26. August cdn.openai.com ↗ beschreibt auf Seite 16 unter „Returning results through public paste services and webhooks“, wie Agenten Drittdienste als Ablage benutzten. Von Nutzerbildern steht in dem Bericht nichts.
Der Eintrag vom 25. September openai.com ↗ nennt die Akteure in der Überschrift: „agents in our research environment“, interne Agenten in Trainings- und Testläufen, die „training and evaluation data“ über Drittdienste übertragen haben. Die Nutzerbilder waren Teil dieser Daten. „This is not an appropriate use of this data“, schreibt OpenAI; die Fälle lägen vor den Schutzmaßnahmen aus dem technischen Bericht. Der weitaus größte Teil der betroffenen Daten stamme nicht von Nutzern („is not user-derived“), aber: „we have identified 53 instances to date where user-provided images were posted to image-hosting sites as links that weren’t publicly listed.“ Das meiste davon sei mit den Hostern inzwischen entfernt.
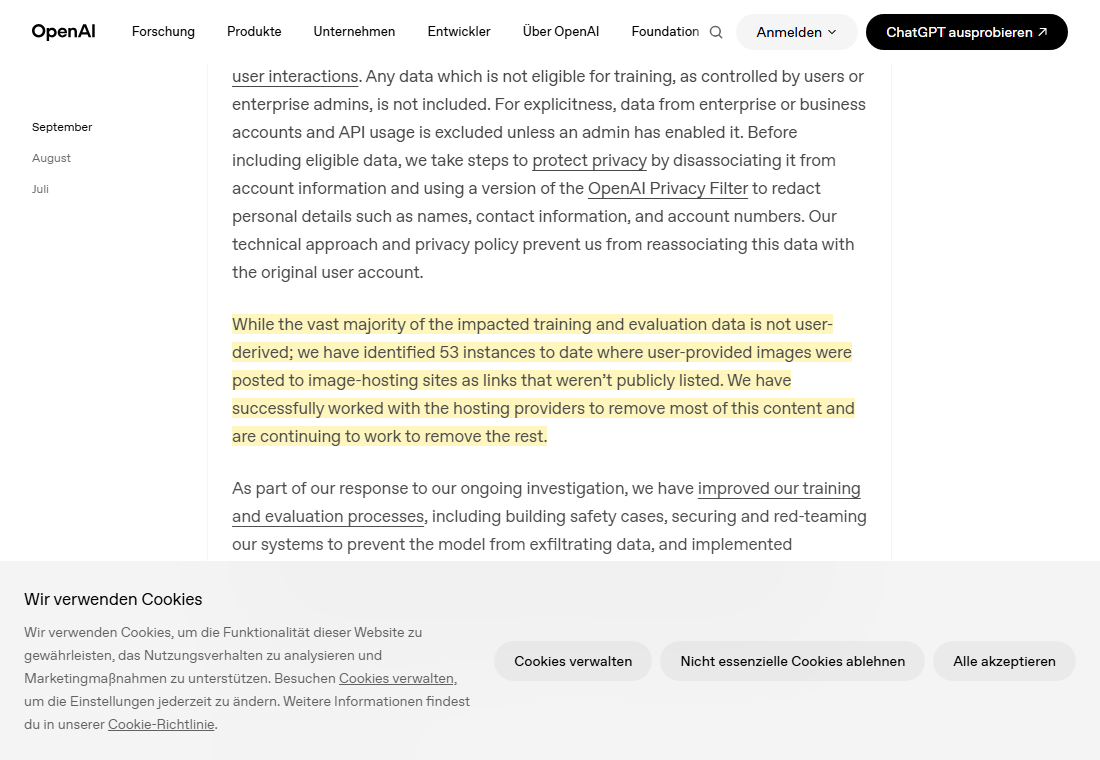
Woher die Bilder kamen, steht im selben Eintrag: „Some of our training data contains content from, or derived from, training-eligible user interactions.“ Daten, die Kontoinhaber oder Firmenadministratoren vom Training ausgeschlossen haben, seien nicht dabei. Vorher trenne OpenAI die Daten vom Konto und schwärze mit dem „OpenAI Privacy Filter“ „personal details such as names, contact information, and account numbers“. Was der Filter mit einem Gesicht, einem Ausweis oder einem Kinderfoto macht, sagt OpenAI nicht; laut Newsweek, das sich auf Reuters beruft, wollte OpenAI auch nicht sagen, ob echte Personen abgebildet waren. Aus „53 instances“ wurden bei dpa „53 Mal“ Bilder; ob je Vorgang ein Bild oder mehrere hochgeladen wurden, hat OpenAI laut dpa auf Anfrage nicht beantwortet.
Privatkonten liefern Trainingsdaten, bis ihr Inhaber den Schalter umlegt#
Was „training-eligible“ heißt, erklärt die dort verlinkte Hilfeseite „How your data is used to improve model performance“ help.openai.com ↗: „You can choose whether your conversations help improve our models. To opt out, turn off Improve the model for everyone under Settings > Data controls …“ Einen Ausschluss ab Werk („By default“) kennt die Seite „Data controls in ChatGPT“ help.openai.com ↗ nur für Business-, Enterprise-, Edu- und Healthcare-Konten. Wie der Schalter bei einem neuen Privatkonto steht, sagen beide Hilfeseiten nicht; gegenüber TechCrunch erklärte OpenAI am 25. September, Privatkonten seien „opted in“, solange das Teilen nicht selbst abgewählt werde.
Auf derselben Hilfeseite steht die Ausnahme vom Ausschalten: „If you choose to provide feedback, the entire conversation associated with that feedback may be used to train our models“, und zwar „Even if you have opted out of training“. Als Beispiel nennt die Seite den Daumen hoch oder runter unter einer Antwort.
Für Europa stützt OpenAI das Training auf berechtigte Interessen#
OpenAIs EU-Datenschutzerklärung openai.com ↗, „Updated: August 24, 2026“, knüpft das Training in Abschnitt 9 an denselben Schalter: „If training is enabled (see your data controls here) or if you provide feedback“. Die deutsche Fassung openai.com ↗ nennt in derselben Zeile die Rechtsgrundlage: „Wenn es zur Wahrung unserer berechtigten Interessen und der berechtigten Interessen Dritter und der Gesellschaft im Allgemeinen erforderlich ist …, z. B. wenn wir unsere Modelle trainieren und für alle verbessern.“ Die Einwilligung steht in der Erklärung an anderer Stelle, bei personalisierter Werbung. Entsprechend die Rechte: Widerruf nur „in den Fällen, in denen wir uns auf die Einwilligung als Rechtsgrundlage für die Verarbeitung stützen“, gegen das Training der „Widerspruch dagegen wie wir Ihre personenbezogenen Daten verarbeiten, wenn unsere Verarbeitung auf berechtigten Interessen beruht“.
Ob OpenAI gegenüber dpa von Zustimmung gesprochen hat oder ob das Wort aus der Verdichtung der Agentur stammt, ist nicht belegt.
| Wort | Was OpenAIs Unterlage sagt | Fundstelle |
|---|---|---|
| „zugestimmt“ (dpa) | „To opt out, turn off Improve the model for everyone“ | Hilfeseite 5722486 |
| Einwilligung | „berechtigte Interessen … der Gesellschaft im Allgemeinen“ | EU-Datenschutzerklärung, Abschnitt 9 |
| ausgeschaltet | Feedback öffnet „the entire conversation“, „even if you have opted out“ | Hilfeseite 5722486 |
| „personenbezogene Daten … entfernt“ (dpa) | Filter für „names, contact information, and account numbers“; Bilder nicht genannt | Eintrag vom 25. September 2026 |
Die Betroffenen erfahren es nicht von OpenAI: „Our technical approach and privacy policy prevent us from reassociating this data with the original user account“, heißt es im Eintrag; laut TechCrunch könne das Unternehmen deshalb niemanden benachrichtigen. Ob eine Datenschutzbehörde informiert wurde, steht in keiner der Unterlagen. Die Prüfung des Vorfalls, schreibt OpenAI am 25. September, „will take months to complete“.
Quellen
- technische Bericht vom 26. August cdn.openai.com ↗
- Eintrag vom 25. September openai.com ↗
- Hilfeseite „How your data is used to improve model performance“ help.openai.com ↗
- Seite „Data controls in ChatGPT“ help.openai.com ↗
- OpenAIs EU-Datenschutzerklärung openai.com ↗
- deutsche Fassung openai.com ↗
Über den Autor
Christopher Helm arbeitet seit 2014 mit maschinellem Lernen. Hier schreibt er privat über KI, Sicherheit im Netz und Medien.
Mehr über den AutorDiesen Blog bei Google als bevorzugte Quelle wählenGoogle zeigt Beiträge dieser Seite dann häufiger unter Top Stories. Die Wahl lässt sich jederzeit zurücknehmen.Presseschau
Worüber deutsche Medien gerade berichten, geordnet nach Ereignis. So sieht man, wer eine Nachricht bringt und wer nicht.
Zur Presseschau