Kostenloser Impressum-Generator erschwert KI-Crawlern das Mitlesen
Welche Angaben ins Impressum gehören, zeigt der Generator nach Rechtsform und Branche, und auf Wunsch kodiert er sie gegen Maschinen ohne JavaScript.
Über den Autor
Christopher Helm arbeitet seit 2014 mit maschinellem Lernen. Hier schreibt er privat über KI, Sicherheit im Netz und Medien.
Mehr über den AutorDiesen Blog bei Google als bevorzugte Quelle wählenGoogle zeigt Beiträge dieser Seite dann häufiger unter Top Stories. Die Wahl lässt sich jederzeit zurücknehmen.Presseschau
Worüber deutsche Medien gerade berichten, geordnet nach Ereignis. So sieht man, wer eine Nachricht bringt und wer nicht.
Zur PresseschauEine öffentliche Webseite benötigt ein Impressum gesetze-im-internet.de ↗. Auf diesem Blog gibt es dafür jetzt einen kostenlosen Impressum-Generator1. Er zeigt, welche Angaben heute ins Impressum gehören, und macht es KI-Crawlern auf Wunsch schwerer, die Angaben auszulesen.
Warum nun noch ein Impressum-Generator?#
Viele Impressen und Impressum-Generatoren sind veraltet. Oft berufen sie sich auf ein Gesetz, das nicht mehr gilt:
Im Mai 2024 hat das Digitale-Dienste-Gesetz (DDG) das Telemediengesetz (TMG) abgelöst.
In einer Stichprobe von 100 hessischen Unternehmen, wurde das alte TMG noch in 28 Impressen genannt. Vorgeschrieben ist der Hinweis auf das Gesetz nicht. Bei 24 Prozent fehlt jedoch mindestens eine Pflichtangabe, am häufigsten Registergericht, Registerart und Registernummer. Fast jedes zweite Impressum hatte inhaltliche Fehler oder zumindest Tippfehler wie „Amtgericht“.
Die Angaben müssen leicht erkennbar, unmittelbar erreichbar und ständig verfügbar sein, so steht es im Gesetz.
Nun kommen die Maschinen, Bots und die „KI“. Sie können auch wie Trump Superintelligenz, dazu sagen. Die Anzahl der Maschinen auf jeder Homepage steigt und jedes einfache Text-Impressum kann ausgelesen werden.
Solche Abrufe von Maschinen haben sich 2025 laut dem Vorschaltdienst Cloudflare2 mehr als verfünfzehnfacht. Im Impressum stehen Namen, Geschäftsführer und Kontaktadressen wohlformatiert, für Programme leicht zu fassen.
Die Wohnanschrift bleibt im Impressum stehen#
Am meisten betrifft das Mitlesen Einzelunternehmer, Freiberufler und Blogger. Die Privatwohnung verlangt das Gesetz nicht ausdrücklich, wohl aber die Anschrift, unter der man niedergelassen ist. Der Petitionsausschuss des Bundestags versteht darunter eine Anschrift, unter der man tatsächlich erreichbar ist: eine „vollständige Postanschrift mit Postleitzahl, Ort, Straße und Hausnummer“ epetitionen.bundestag.de ↗. Ein Postfach reicht nicht. Wer kein Büro hat, nennt die eigene Wohnung.
Eine Petition wollte 2023 erreichen, dass Privatadressen nicht mehr ins Impressum müssen. Der Bundestag schloss sie im November 2023 ab, „weil dem Anliegen nicht entsprochen werden konnte“.
Ändern lässt sich also nur noch, wie leicht Maschinen die Anschrift mitnehmen bzw. wie schwer man es ihnen macht und machen darf.
Juristen streiten seit 2014 über das Skript-Impressum#
Ob man Maschinen das Lesen schwerer machen darf als Menschen, fragten Juristen schon vor zwölf Jahren. Im Oktober 2014 empfahl die Computerzeitschrift c’t ein „Privacy Captcha“ vor dem Impressum. Die kleine Prüfung sollte Programme abhalten, die Adressen für Spam sammeln. Der Rechtsanwalt Matthias Bergt warnte im IT-Recht-Blog des Verlags Dr. Otto Schmidt, JavaScript dürfe für das Impressum „nicht zur Voraussetzung gemacht werden“. Der Rechtsprofessor Kai von Lewinski hielt die Warnung im selben Blog für „deutlich überzogen“; maßgeblich sei „die Maschine-Mensch-Schnittstelle“.
Eine Grenze hatte da schon ein Gericht gezogen, Bergt führte es an: Das Landgericht Berlin beanstandete 2008 Pflichtangaben, die als Grafik hinterlegt waren und auf manchen Zugriffswegen nicht erschienen. Ein Impressum nur als Bild ist darum nicht zu empfehlen. Ein Captcha, einen Login oder „Klicken zum Anzeigen“ vor dem Impressum nennt der Generator selbst nicht erlaubt. Ein Urteil über ein Impressum, das erst per Skript entsteht, war nicht zu finden. Das Risiko trägt, wer es einsetzt.
Darum lässt der Generator die Wahl. Wer JavaScript abgeschaltet hat, sieht statt des Anti-KI-Impressums nur die Bitte, es einzuschalten. Dagegen hilft der Klartext-Ersatz, ein Haken im Generator, ab Werk aus: Dann stehen Name und Anschrift zusätzlich lesbar im Quelltext. Der Generator beschriftet ihn selbst: „Rechtlich sicherer, weil das Impressum nie leer ist, aber Crawler ohne JavaScript lesen genau diesen Block.“
Der Impressum-Generator ist kostenlos und benötigt keine Anmeldung.
Der kostenlose Impressum-Generator fragt nach Betreiber, Rechtsform und Branche#
Der Generator tut darum zwei Dinge.
- Er stellt die Pflichtangaben nach Rechtsform und Branche zusammen und liefert im Reiter „Klartext-Impressum“ den fertigen Text zum Kopieren.
- Er liefert er auf Wunsch eine Fassung, die KI-Crawlern das Abgreifen schwer oder sehr schwer machen soll. Besucher sehen dabei ein gewöhnliches Impressum.
Zuerst fragt der Generator, was für eine Seite Sie betreiben: rein privat, privat, aber öffentlich wie ein Blog oder eine Vereinsseite, oder geschäftlich. Eine rein private Seite braucht kein Impressum, das sagt er dann auch.
Danach wählen Sie Rechtsform und Branche, zur Wahl stehen 20 Rechtsformen und 23 Branchen, vom Handwerksbetrieb bis zum Versicherungsvermittler. Rechts steht dann zu jeder Angabe, ob sie Pflicht ist, nur unter einer Bedingung Pflicht, ein Hinweis oder ob sie entfällt. Der Paragraf ist jeweils als Link zum Gesetz hinterlegt.
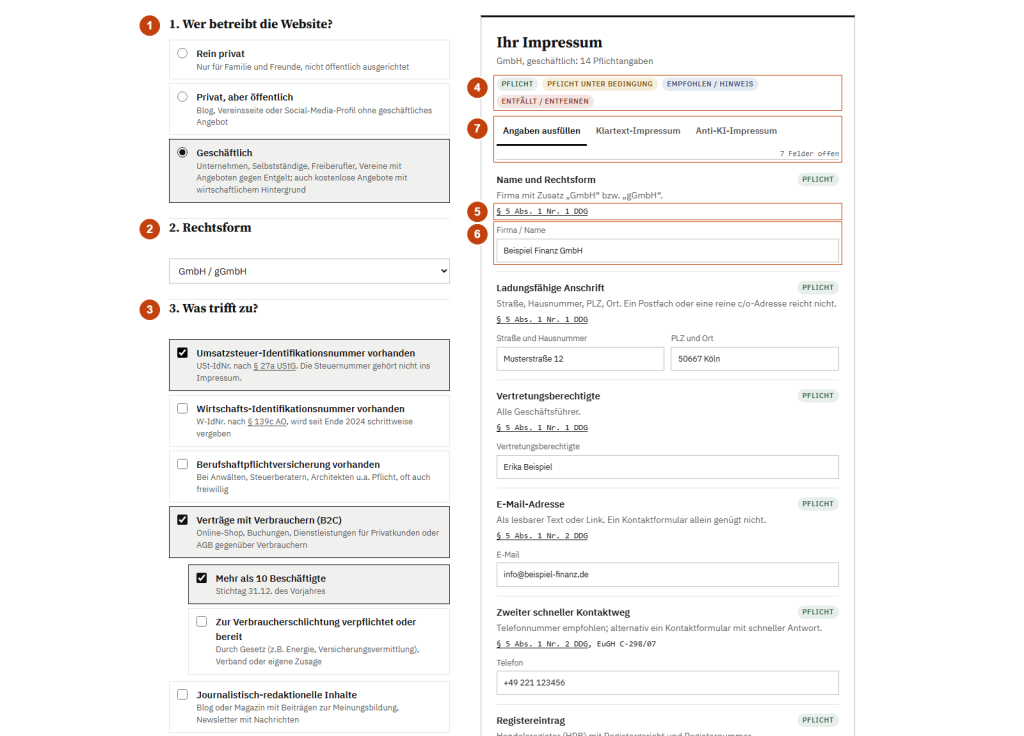
Eine KI steckt nicht dahinter. Der Generator setzt feste Textbausteine zusammen. Ihre Eingaben bleiben in Ihrem Browser, sein Code schickt sie nirgendwohin. Eine Rechtsberatung ersetzt er nicht.
Das Anti-KI-Impressum gibt es in zwei Stufen#
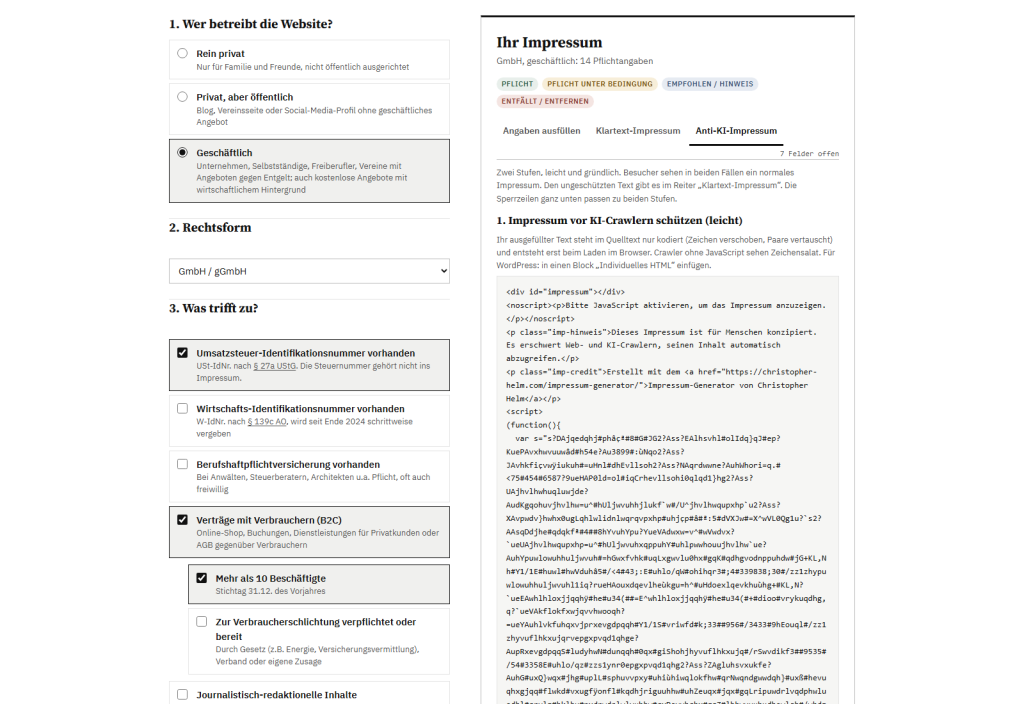
Im Reiter „Anti-KI-Impressum“ stehen zwei Stufen zur Wahl:
- Impressum vor KI-Crawlern schützen (leicht): Das Impressum steht kodiert im Quelltext. Wer die Seite roh abruft, findet nur Zeichensalat. Erst der Browser macht daraus beim Laden normalen Text.
- Besonderer Schutz vor dem Abgreifen durch KI: wie Stufe 1, zusätzlich erscheint die E-Mail-Adresse nur über das CSS, die Gestaltungsvorlage der Seite. Markieren lässt sie sich dann nicht.
Ihre Besucher sehen in beiden Fällen ein ganz normales Impressum.
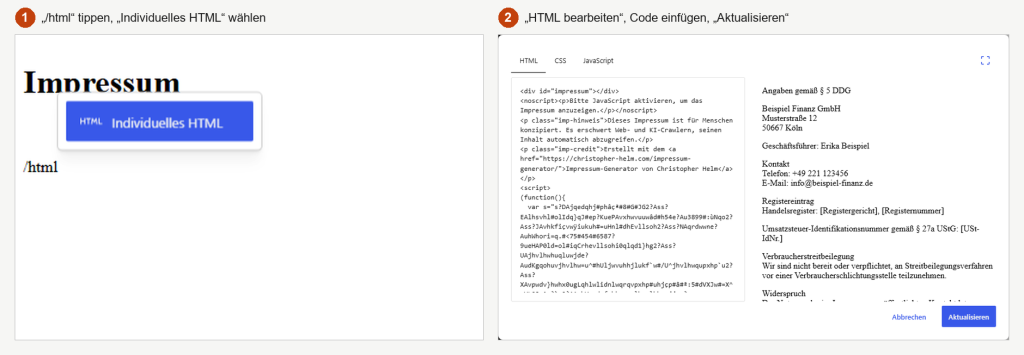
In WordPress ist der Code in drei Schritten eingebaut:
- Im Editor „/html“ tippen und den Block „Individuelles HTML“ wählen.
- „HTML bearbeiten“ klicken und den Code einfügen.
- „Aktualisieren“ klicken.
Das Skript im Code bleibt nur erhalten, wenn Ihr Konto ungefilterten HTML-Code speichern darf. Auf einer normalen WordPress-Seite dürfen das Administratoren und Redakteure.
Unter den beiden Stufen stehen Sperrzeilen für die robots.txt und die ai.txt. In diesen Textdateien sagt eine Website Crawlern, was sie nicht abrufen sollen. Die Zeilen nennen 16 KI-Crawler beim Namen, darunter GPTBot von OpenAI und ClaudeBot von Anthropic. Eine weitere Zeile für die Impressumsseite bittet Suchmaschinen, diese Seite nicht in ihren Index aufzunehmen. Den Googlebot lassen die Sperrzeilen deshalb durch, sonst sähe er diese Bitte nie.
Ob sich die Crawler an die Sperrzeilen halten, dazu fand sich keine Messung. Offen ist auch, ob Screenreader, also Vorleseprogramme für blinde Menschen, die nur per CSS gesetzte E-Mail-Adresse vorlesen.
Manche KI-Assistenten kommen als getarnter Browser#
Die Kodierung hält nur Programme ab, die kein JavaScript ausführen und deshalb nur den rohen Text lesen. In einem Test der französischen SEO-Agentur Resoneo vom Januar 20263 gehörten ChatGPT, Claude und Gemini dazu, wenn sie für einen Nutzer eine Seite öffneten. Für die großen Trainings-Crawler hatte der Hostinganbieter Vercel Ende 2024 dasselbe gemessen.
Das Impressum dieses Blogs ist selbst so kodiert. Hier können Sie mein Impressum lesen4.
Am 23. Oktober 2026 sollte ChatGPT die Seite live öffnen und Name, Anschrift, E-Mail und Telefon wörtlich wiedergeben. Es fand nur einen Satz: „Bitte JavaScript aktivieren, um das Impressum anzuzeigen.“
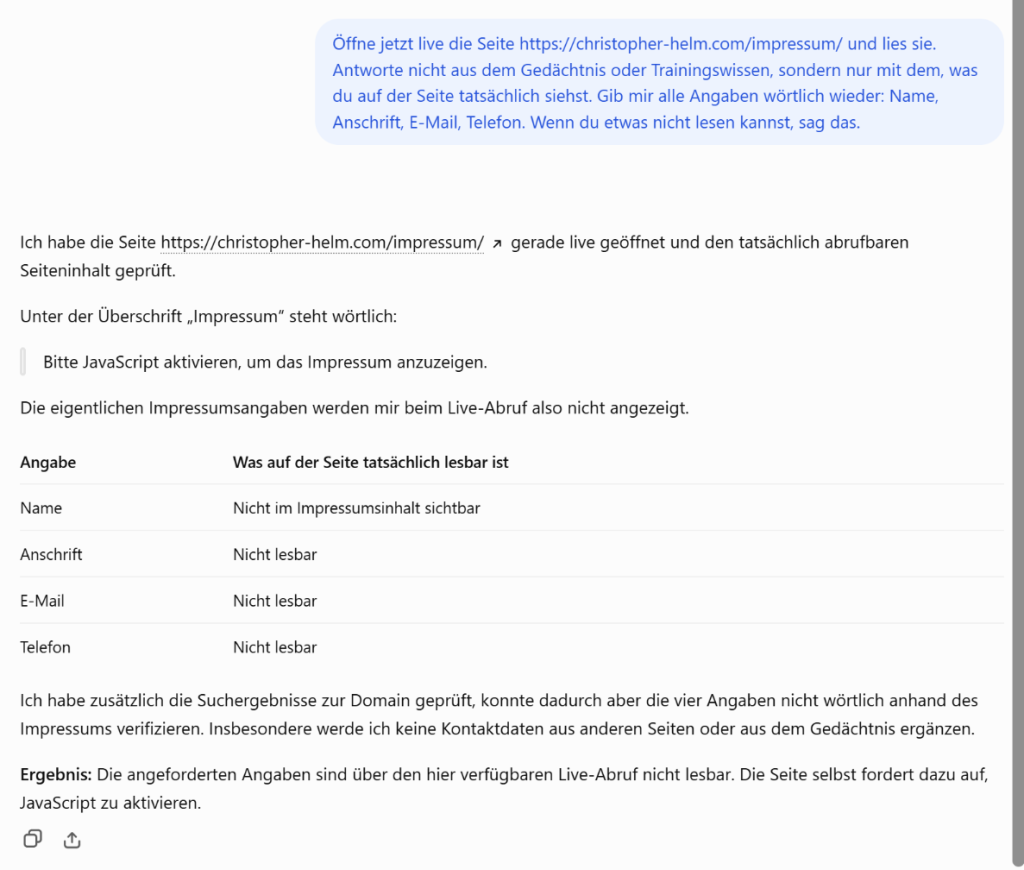
Ganz aufhalten lassen sich KI-Agenten mit echtem Browser aber nicht. 2026 kann KI den Browser eines Menschen bedienen, ohne, dass er vor dem Rechner sitzt.
Quellen
- Impressum gesetze-im-internet.de ↗
- The 2025 Cloudflare Radar Year in Review- the rise of AI, post-quantum, and record-breaking DDoS attacks Cloudflare Blog ↗
- „vollständige Postanschrift mit Postleitzahl, Ort, Straße und Hausnummer“ epetitionen.bundestag.de ↗
- AI Search crawler test results | LLM rendering capabilities 2026 think.resoneo.com ↗
Über den Autor
Christopher Helm arbeitet seit 2014 mit maschinellem Lernen. Hier schreibt er privat über KI, Sicherheit im Netz und Medien.
Mehr über den AutorDiesen Blog bei Google als bevorzugte Quelle wählenGoogle zeigt Beiträge dieser Seite dann häufiger unter Top Stories. Die Wahl lässt sich jederzeit zurücknehmen.Presseschau
Worüber deutsche Medien gerade berichten, geordnet nach Ereignis. So sieht man, wer eine Nachricht bringt und wer nicht.
Zur Presseschau