Werbung und Journalismus: Die Unterscheidbarkeit sinkt
Verlage verwischen die Kennzeichnung selbst, Betrüger kapern dieselben Werbeplätze. Funde bei Ippen, Handelsblatt und Bild.de, dazu eine eigene Messung.
Über den Autor
Christopher Helm arbeitet seit 2014 mit maschinellem Lernen. Hier schreibt er privat über KI, Sicherheit im Netz und Medien.
Mehr über den AutorDiesen Blog bei Google als bevorzugte Quelle wählenGoogle zeigt Beiträge dieser Seite dann häufiger unter Top Stories. Die Wahl lässt sich jederzeit zurücknehmen.Presseschau
Worüber deutsche Medien gerade berichten, geordnet nach Ereignis. So sieht man, wer eine Nachricht bringt und wer nicht.
Zur PresseschauDass ein Verlag Werbung schaltet, ist das kleinere Problem. Interessanter ist, wie eine Seite ganz ohne journalistischen Anspruch überhaupt Leser findet, ein Portal, das nur existiert, um Aufmerksamkeit abzufischen. Die Menge an Werbung auf den etablierten Seiten scheint längst nichts Anrüchiges mehr zu sein. Wer sich auf welt.de oder t-online.de ohnehin durch Anzeigen, Empfehlungskacheln und Zählpixel arbeitet, dem dürfte am Ende gleich sein, ob hinter der Seite eine Redaktion steht oder nur der Werbeplatz. Die Schwelle, ab der Werbung als zu viel auffällt, haben vermutlich nicht die Content-Farmen gesenkt, sondern die Häuser mit Redaktion, im eigenen Geschäft, über Jahre. Dieselbe Gewöhnung, die den Anzeigenverkauf der Verlage trägt, deckt am Ende die Seite ohne Redaktion, die von nichts anderem lebt. Je weniger ein Leser Redaktion vom Werbeplatz trennen kann, desto weniger ist ihm die Trennung wert.
Zwischen Werbung und Journalismus verläuft eine Grenze: ein Wort über dem Text, ein Name, der für eine Recherche bürgt. Zwei Übermedien-Recherchen im April und im Juni 2026 haben sie an je einem Haus geprüft: am Handelsblatt, das Werbetexte im Layout eines redaktionellen Beitrags zeigt, und am Ippen-Verlag, dessen Portale ein externer Kooperationspartner mit KI-gestützten Texten beliefert. Beim Handelsblatt trägt der Text ein Autorenprofil, nur stammt es von einem PR-Agentur-Mitarbeiter statt aus der Redaktion; bei Ippen fehlt trotz eigener Leitlinien jedes Autorenprofil, und wer die KI-Texte schreibt, bleibt offen. Die Grenze steht in § 22 des Medienstaatsvertrags, in der Redaktionsrichtlinie, in Ziffer 7.1 des Pressekodex. Gezogen hat sie vor der Veröffentlichung in keinem der beiden Fälle jemand.
Bei Ippens KI-News-Kooperation bleibt von der Trennung nur das Wort „Kooperation“ übrig
Laut der Übermedien-Recherche vom 29. Juni 20261 liefert der Kooperationspartner News in Five Texte an rund 70 Portale des Ippen-Verlags, darunter fr.de, HNA.de und Merkur.de. Hinter News in Five steht Florian Stickel. Unter dem Namen Lukas Richter erschienen bei fr.de binnen zwei Wochen mehr als 50 Artikel; im eigenen Impressum räumt News in Five ein, KI-Tools von OpenAI, Google und Microsoft „zur Korrektur und Überarbeitung von Inhalten“ einzusetzen. Ein Autorenprofil, wie es Ippens eigene Leitlinien vorsehen, fehlt. Sichtbar ist allein der Hinweis, der Text sei „in Kooperation mit newsinfive.de“ entstanden; ob am einzelnen Artikel KI-Software beteiligt war, bleibt offen. Eine Stufe weiter liegt it-boltwise: Dort fehlt nicht nur das Profil, sondern die Person. Das IT-Nachrichtenportal übersetzt Hacker-News-Artikel automatisiert und erfindet die Autorin gleich mit: „Nimm die Werbe-Widgets weg, und es bleibt nichts“, heißt es im eigenen Text dazu. Die genannte Autorin existiert nicht.
Auch beim Handelsblatt wird die Grenze erst vor Gericht gezogen: § 22 des Medienstaatsvertrags schreibt die Trennung vor, erzwingen muss sie ein Urteil
Die Übermedien-Recherche vom 14. April 20262 beschreibt ein Advertorial für die Kryptobörse Bitpanda: ein unauffälliger „Anzeige“-Balken, dazu Affiliate-Links, deren Offenlegung erst am Seitenende folgt. Daneben steht ein Verifizierungshäkchen: Es sieht nach einem geprüften redaktionellen Autor aus und weist einen Mitarbeiter der Werbeabteilung aus. Die Verbraucherzentrale Baden-Württemberg3 klagt deswegen vor dem Landgericht Düsseldorf gegen die Handelsblatt GmbH, ein Verfahren bislang ohne Termin. „Verbraucher:innen erkennen den werblichen Charakter des Textes eher zufällig, wenn sie ganz genau hinschauen“, sagt die Verbraucherzentrale. Über einen verwandten Vorwurf, mangelnde Trennung von Werbung und Inhalt, urteilte das Landgericht Bamberg bereits am 11. März 2026 gegen Google (Az. 1 HK O 19/25, nicht rechtskräftig). In einem gesponserten YouTube-Clip eines Influencers stand der Hinweis „Enthält bezahlte Werbung“ nur in den ersten zehn Sekunden von zehn Minuten, und in der Beschreibung war der Sponsor falsch benannt. Anders als beim EU-Verbraucherschutz, wo dem Recht selbst das Vollzugsinstrument fehlt („EU-Verbraucherschutz: Der Rahmen steht, das Instrument fehlt“4), gibt es hier ein Instrument. Nur der Termin fehlt.
Zwei unabhängige Prüfungen finden bei Bild.de den gleichen Befund: Werbung ohne Anzeige-Kennzeichnung
Die netzpolitik.org-Erhebung vom 3. März 20255 untersuchte die zehn reichweitenstärksten Nachrichtenportale nach IVW-Ranking, Stichtag war der 20./21. Februar 2025. Bei bild.de kostet eine „Product-Story“ 79.000 Euro; Formate wie „Sportwetten mit PayPal“ tragen den Hinweis „Anzeige“, andere, etwa ein „JOYclub“-Test, keinerlei Kennzeichnung. Bei t-online.de trägt ein Artikel wie „Amazon reduziert Testsiegel-Steuersoftware“ keinen Werbehinweis, nur die eingebetteten Links sind mit „Anzeige“ markiert. Mehr als ein Jahr später, in der Presserats-Sitzung vom Juni 20266, taucht bild.de erneut auf: Unter 149 geprüften Beschwerden sprach der Presserat 18 öffentliche Rügen aus, mehrere davon wegen Schleichwerbung; eine nennt bild.de namentlich. Der eigene Beitrag „Die dunkle Seite der KI im Journalismus: 1.500 KI-Texte im Eilverfahren pro Tag, über eine Million Besucher im Monat“ beziffert das Tempo: 1.500 neue Texte am Tag stehen 18 Rügen pro Presserats-Sitzung gegenüber.
Warum Tarnung wirkt: Bis zu 60 Prozent erkennen bezahlte Inhalte nicht als solche
Die ZHAW-Studie „Native Ads erkennen und beurteilen“ zhaw.ch ↗ befragte 2021 im Auftrag der Schweizer Bundesbehörde BAKOM 1.800 Teilnehmende in der Deutsch- und Westschweiz. Je nach Plattform erkannten bis zu 60 Prozent der Befragten Native Ads nicht als bezahlten Inhalt. Ein Eye-Tracking-Teil der Studie zeigt, warum: Hinweise außerhalb des eigentlichen Textes werden routinemäßig übersehen. Studienleiter Guido Keel überträgt das Muster gegenüber netzpolitik.org auch auf deutsche Portale, ohne dafür eine eigene Erhebung zu haben: „Im Schnitt hat ein Drittel die Native Ads nicht als solche erkannt. Bei gewissen Medien waren es über 50 Prozent.“ Die Kennzeichnungshinweise auf Ippen-, Handelsblatt- und Bild-Seiten liegen in derselben Randlage wie in der Studie: bei Ippen nur als allgemeine „Kooperation“ ausgewiesen, bei Handelsblatt als unauffälliger Anzeige-Balken, bei Bild laut netzpolitik.org-Stichprobe teils gar nicht gesetzt. Ist Aufmerksamkeit das knappe Gut, wie es der eigene Text „KI überfischt nicht die Information, sondern die Aufmerksamkeit“ beschreibt, dann kostet auch der Blick auf einen Kennzeichnungshinweis etwas, das die meisten Leser nicht aufbringen.
Wie viel vom Bildschirm Werbung einnimmt, zählt niemand nach
Wie viel der sichtbaren Fläche auf web.de, t-online.de oder GMX Werbung einnimmt, hat niemand öffentlich nachprüfbar gemessen. Branchen-Richtwerte wie Googles Empfehlung eines mobilen Ad-Density-Anteils unter 30 Prozent der Seitenhöhe oder Sichtbarkeitsraten aus Viewability-Reports messen etwas anderes: nicht, wie viel Fläche Werbung einnimmt, sondern ob eingeblendete Werbung überhaupt im sichtbaren Bereich landet. Für die konkreten Reichweiten-Portale, um die es hier geht, bleibt die Zahl offen. Damit fehlt beiden Seiten die Grundlage für einen Streit: Eine Aufsichtsbehörde kann keinen Grenzwert durchsetzen, den niemand erhebt, und ein Leser, der eine Startseite für überladen hält, hat keine Zahl, mit der er das belegen könnte. „Zu viel“ bleibt Gefühl gegen Gefühl. Der eigene Text „Wer kann sich Wahrheit noch leisten?“ trägt dieselbe Zitronenmarkt-Logik: Der Preis für Qualität sinkt, wenn niemand sie mehr von der Fälschung unterscheidet.
Auf der Verbindungsebene lässt sich zählen, was auf der Fläche niemand misst
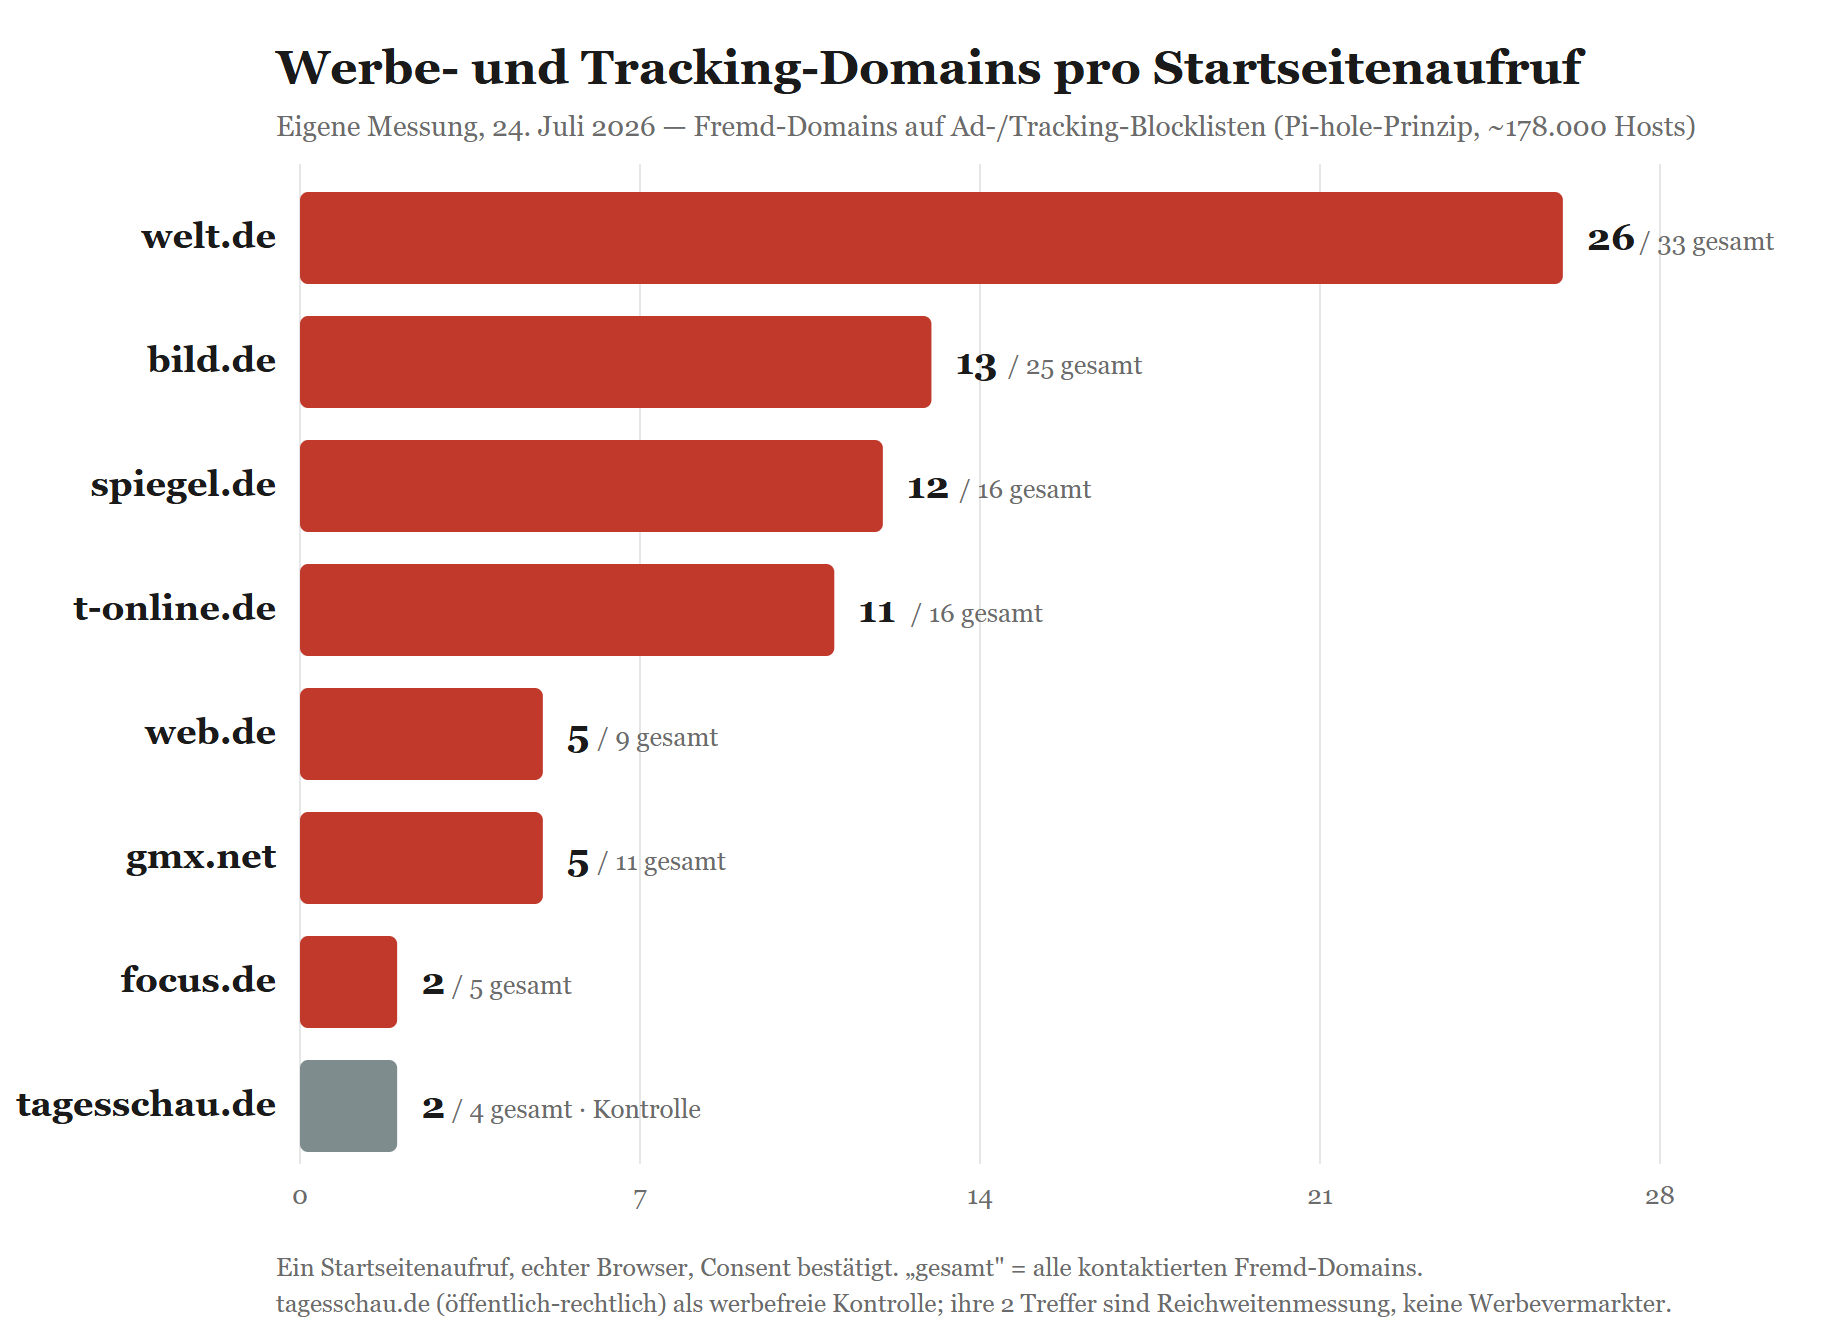
Ruft man eine Startseite mit einem echten Browser auf, lässt sich mitschreiben, welche fremden Server dabei kontaktiert werden. Ein Abgleich mit den Ad- und Tracking-Blocklisten7 eines werbeblockierenden Heim-DNS (Pi-hole-Prinzip, hier rund 178.000 Hosts) trennt Redaktionstechnik von Werbe- und Zählinfrastruktur. Eine eigene Messung am 24. Juli 2026 ergab: Ein einziger Startseitenaufruf kontaktiert bei welt.de 26 verschiedene Werbe- und Tracking-Domains, bei bild.de 13, bei t-online.de 11. Zwischen 45 und 79 Prozent aller angesprochenen Fremd-Domains stehen auf den Blocklisten. Die werbefreie Kontrolle, die öffentlich-rechtliche Startseite tagesschau.de, kontaktiert überhaupt nur vier fremde Domains, zwei davon auf den Listen, und diese messen Reichweite, nicht Werbung. Der Vergleich ist kein Schuldnachweis: Ein gebührenfinanziertes Portal muss keinen Werbemarkt bedienen und lädt schon deshalb weniger; die Kontrolle zeigt die Bandbreite, in der sich dieselbe technische Ebene bewegt. Gezählt ist damit nicht die Werbefläche, sondern die Dichte des Netzes dahinter, und genau dort setzt ein blockierendes DNS an.
Der zweite Fall: eine Domain, die eine ganze Nachrichtenmarke stiehlt
Ein Verlag, der ein Advertorial verkauft, ist nicht dasselbe wie eine Domain, die eine fremde Marke stiehlt. Neben einer echten bild.de-Meldung über einen Wal, der vor der US-Küste auf ein Boot schlug, stand ein Werbelink. Er führte auf eine Wegwerf-Domain mit zufälligem Namen und der Endung „.autos“. Die Zielseite war nicht bloß journalistisch möbliert, sie baute das Layout einer bekannten überregionalen Nachrichtenmarke bis zum Markenkopf nach: Kopfleiste, Ressort-Navigation, Breadcrumb, Datumszeile, Lesezeit. Der Inhalt war frei erfunden: eine nie geschehene Festnahme des Bundesbankpräsidenten, ausgelöst durch ein gefälschtes Fernsehinterview mit den Logos einer realen ZDF-Sendung. Darin legte die Seite einem bekannten Philosophen die Empfehlung einer „Trading“-Plattform mit erfundenem Namen in den Mund, samt Renditeversprechen und gefälschten Bewertungen. Wenige Stunden später war die Domain tot. Vor Seiten, die einen Anlagebetrug als Nachrichtenartikel tarnen, warnen die Verbraucherzentrale8 und das ZDF zdf.de ↗. Unmarkierte Werbung lässt die Kennzeichnung weg; diese Seite übernimmt die ganze Form des Journalismus, bis zur fremden Marke. Für den Moment des Klicks ist die Fälschung von der Meldung, aus der heraus sie verlinkt war, nicht zu unterscheiden.
Wie dieses Umfeld auf der Startseite aussieht, zeigt eine eigene Aufnahme von bild.de. Unter der Überschrift „Mehr aus dem Netz“ stehen Kacheln, die in Bild, Aufmachung und Typografie den redaktionellen Teasern direkt darüber gleichen; als Werbung ausgewiesen sind sie allein durch ein kleines „Anzeige“ in der oberen Ecke. Die Rubrik heißt „aus dem Netz“, nicht „Anzeigen“, obwohl jede Kachel darunter ein bezahlter Werbeplatz ist, und die Kennzeichnung sitzt genau an der Randstelle, die laut ZHAW-Studie routinemäßig übersehen wird. Die Kacheln in dieser Aufnahme führen zu gewöhnlicher Werbung: Wärmepumpe, Heizöl, ein Browser-Spiel. Derselbe Platz trug im geschilderten Fall den Link zur Fälschung.
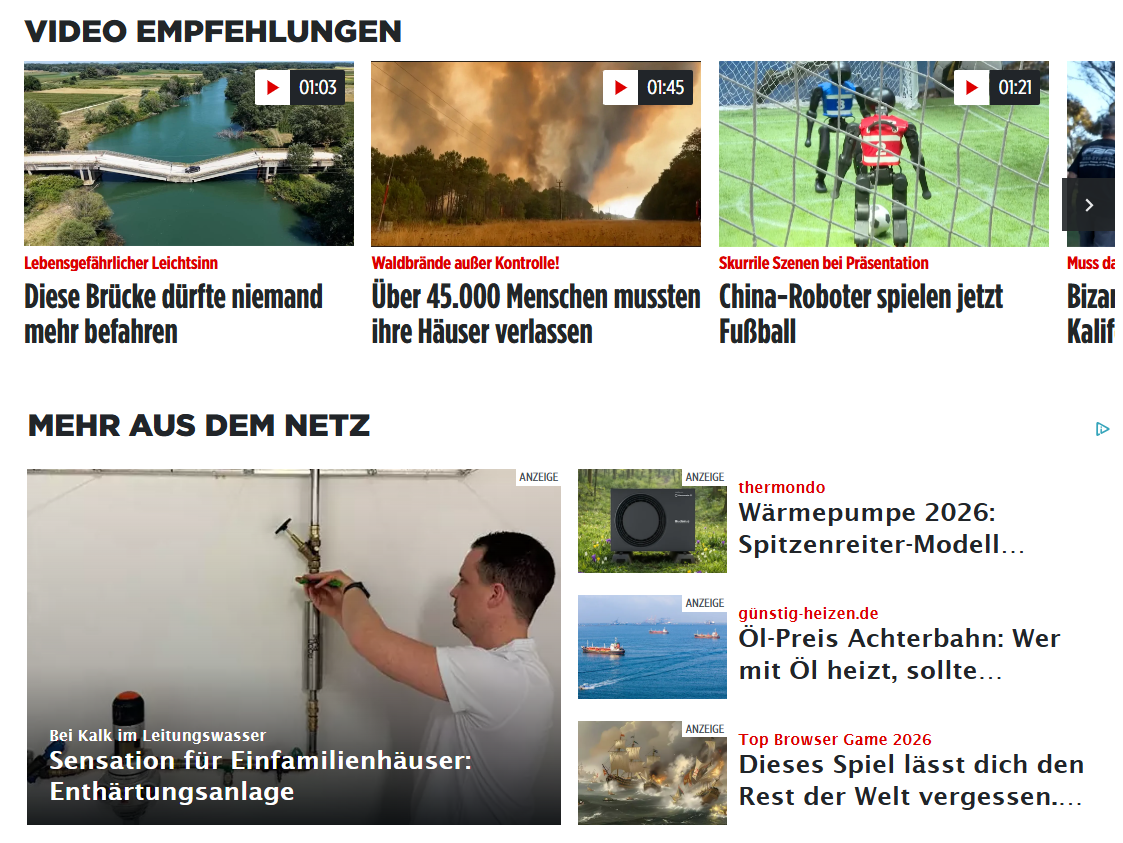
Eigene Aufnahme der bild.de-Startseite. Oben redaktionelle Video-Empfehlungen, darunter „Mehr aus dem Netz“ mit formgleichen Werbekacheln, jede nur durch ein kleines „Anzeige“ in der Ecke gekennzeichnet. Klick öffnet die volle Aufnahme.
Die Zahlen des Reuters Institute beantworten die Schuldfrage nicht
Der Digital News Report 2026 des Reuters Institute9 zeigt, wie selten Klicks überhaupt noch bei der Quelle ankommen. Wer eine Suchmaschine nutzt, klickt zu 44 Prozent oft oder immer zur Originalquelle weiter; in sozialen Netzwerken sind es 36 Prozent, bei einem KI-Chatbot 42. Der eigene Text „Die KI-Antwort nimmt den Klick und verkauft den Platz darin“10 verfolgt den Markt dahinter weiter, in dem ein zitierter Klick mehr wert ist als ein gelesener Artikel. Ob sich Medien durch Kooperationen wie die von Ippen, Advertorials wie das des Handelsblatts oder unklare Kennzeichnung wie bei Bild.de selbst überflüssig gemacht haben, sagen diese Zahlen nicht. Der Preis, den ein Leser für die Unterscheidung noch zu zahlen bereit ist, sinkt aber, sobald er Werbung nicht mehr von Redaktion und einen Rewrite nicht mehr von Recherche trennen kann.
Anhang: So sah die verlinkte Anzeige aus
Der Screenshot zeigt die beschriebene Seite in der Desktop-Ansicht, einen Bildschirm tief. Die als Werbung ausgespielte Seite kopiert den Markenkopf eines überregionalen Nachrichtenmagazins und behauptet, der Bundesbankpräsident sei nach einem Streit mit einem bekannten Philosophen in einer Fernseh-Talkshow am Flughafen festgenommen und sein Privatjet durchsucht worden. Weder die Festnahme noch das Interview lassen sich durch weitere Quellen belegen; die abgebildeten Personen, ihre Namen und die Sender-Logos sind vermutlich ohne ihr Zutun verwendet worden, das nächtliche Jet-Foto ist Kulisse. Der eigentliche Zweck steht am Ende der erfundenen Geschichte: ein Registrierungsformular für ein „Trading“-System, das mit 250 Euro Einsatz 7.000 Euro Monatsgewinn verspricht.

Materialprüfung: Das Bildmaterial weist sich selbst als KI-Produktion aus
Diese gezeigte Seite lag beim Aufruf komplett auf der Wegwerf-Domain: https://xapybeexe.autos. In der größten eingebetteten Bilddatei steckt ein intaktes Herkunfts-Zertifikat nach dem offenen C2PA-Standard. Es nennt als Erzeuger „OpenAI Media Service API“, als Werkzeug das Modell „GPT-4o“ und als Quellenart den Branchen-Code „trainedAlgorithmicMedia“, also: von einem trainierten Modell erzeugt. Wer diese Bilder erstellte, hat das Bild scheinbar von einer Maschine generieren lassen und den maschinenlesbaren Herkunftsnachweis nicht entfernt. Die Fotos sind exakt gleich groß, 1376 mal 768 Pixel; solche festen Kantenlängen liefern typischerweise Generatoren. In keiner Bilddatei stehen die Angaben, die eine Kamera normalerweise hinterlässt: Modell, Belichtung, Objektiv. Die HTML-Seite selbst ist ein Baukasten: Navigations-Icons, Nutzer-Avatare und Bewertungssterne stammen aus einem wiederverwendbaren Vorrat und liegen getrennt von den Motiven, die eigens für diese Kampagne erzeugt und nach Datum abgelegt wurden. Der Klon kopiert nicht nur das Layout einer Nachrichtenmarke, er füllt es mit synthetischem Material, das seine Herkunft im eigenen Dateikopf noch mitführt. Ein Herkunftszertifikat lässt sich allerdings fälschen, und der Snapshot hat die Signatur der Bilddateien beim Speichern beschädigt: Die Spuren sind Indizien, die erst bei forensischer Analyse sichtbar werden und für Leser verborgen bleiben.
Anlass sind zwei Recherchen von Übermedien: „Wer schreibt denn da? Ippens undurchsichtige KI-News-Kooperation“ (29. Juni 2026) und „Advertorials im Handelsblatt: Diese Werbung hat einen Haken“ (14. April 2026), beide von Boris Rosenkranz. Zahlen und Zitate zusätzlich aus der Pressemeldung der Verbraucherzentrale Baden-Württemberg, der Native-Advertising-Erhebung von netzpolitik.org (Martin Schwarzbeck, 3. März 2025), der ZHAW/BAKOM-Studie „Native Ads erkennen und beurteilen“ (2021), dem Digital News Report 2026 des Reuters Institute sowie den Presserat- und BDZV-Meldungen zur Rügenpraxis der Sitzung Juni 2026.
Quellen
- „Zur Teamstruktur äußern wir uns nicht“: Ippen Media und seine undurchsichtige News-Kooperation Übermedien ↗
- „Ganz genau hinschauen“: Diese Werbung hat einen Haken Übermedien ↗
- Werbung muss klar erkennbar sein verbraucherzentrale-bawue.de ↗
- So gefährlich und verbreitet ist Werbung, die wie Journalismus aussieht netzpolitik.org ↗
- Presserat spricht 18 Rügen aus bdzv.de ↗
- ZHAW-Studie „Native Ads erkennen und beurteilen“ zhaw.ch ↗
- The Big Blocklist Collection firebog.net ↗
- Täuschend echt: Wie Kriminelle Deepfakes mit Promis für Fake-Werbung nutzen Verbraucherzentrale.de ↗
- das ZDF zdf.de ↗
- Overview and key findings of the 2026 Digital News Report reutersinstitute.politics.ox.ac.uk ↗
Über den Autor
Christopher Helm arbeitet seit 2014 mit maschinellem Lernen. Hier schreibt er privat über KI, Sicherheit im Netz und Medien.
Mehr über den AutorDiesen Blog bei Google als bevorzugte Quelle wählenGoogle zeigt Beiträge dieser Seite dann häufiger unter Top Stories. Die Wahl lässt sich jederzeit zurücknehmen.Presseschau
Worüber deutsche Medien gerade berichten, geordnet nach Ereignis. So sieht man, wer eine Nachricht bringt und wer nicht.
Zur Presseschau